Tear Model Immersive
Immersive
Durata: 6 min.
venerdì, 09 ottobre 2026 | 13:05 > 13:112026-10-09T13:05:00.000Z | Immersive Room
Anno: 2026
Tecnica: TouchDesigner, visione artificiale, intelligenza artificiale generativa
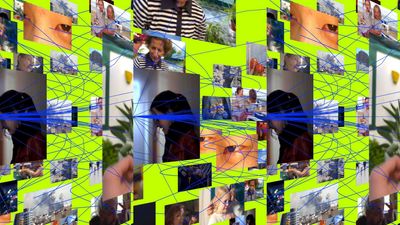
Tear Model è un’opera immersiva che esplora la possibilità di una emozione artificiale attraverso il linguaggio della computazione. Combinando immagini generative, machine vision, intelligenza artificiale ed elaborazione audiovisiva in tempo reale, l’opera mette in scena un esperimento nel quale un’entità artificiale viene esposta a immagini associate al dolore, all’empatia e alla memoria umana.
L’entità non vede né sperimenta queste immagini come farebbe un essere umano. Ogni video viene campionato in singoli frame e sottoposto a una catena di percezione artificiale. Un modello di machine vision traduce innanzitutto l’input visivo in linguaggio; successivamente, un large language model interpreta questa descrizione attraverso un framework affettivo predefinito, stimando parametri come emozione, valenza, attivazione, carico cognitivo, memorabilità e risposta motivazionale. L’immagine viene così progressivamente trasformata da input visivo a linguaggio e da linguaggio a dato emozionale.
Questi valori entrano a far parte della composizione audiovisiva stessa, influenzando il comportamento generativo visivo e sonoro dell’ambiente immersivo. L’intelligenza artificiale non viene quindi utilizzata semplicemente come strumento per generare immagini, ma come un apparato emozionale speculativo: un sistema che tenta di costruire un modello computazionale di cosa significhi essere influenzati da ciò che si osserva. Più che chiedersi se una macchina possa realmente provare emozioni, Tear Model indaga come queste possano essere osservate, classificate, misurate e simulate.
Ogni input visivo diventa una costellazione di parametri, probabilità e valori, suggerendo che l’esperienza emozionale possa essere considerata non soltanto come qualcosa che viene vissuto, ma anche come qualcosa che può essere modellato. Progressivamente, però, l’esperimento rivolge il proprio sguardo verso il pubblico. L’entità artificiale non si stanca di ciò che vede, non scorre oltre e non si abitua a un’immagine semplicemente perché l’ha incontrata molte volte. La percezione umana, al contrario, è condizionata dalla ripetizione, dal contesto, dalla narrazione e dall’assuefazione.
Se un’intelligenza artificiale può continuare a riconoscere schemi di tristezza, perdita e sofferenza mentre gli esseri umani finiscono progressivamente per ignorarli o diventarne insensibili, che cosa definisce allora la nostra umanità? Essere umani significa provare emozioni, riconoscerle negli altri oppure scegliere di reagire a esse?
Tra speculazione scientifica e finzione poetica, Tear Model non cerca di dimostrare che le macchine possano provare emozioni. Utilizza invece la possibilità di un’empatia artificiale per mettere in discussione la nostra. Se le emozioni possono essere previste, classificate e simulate, che cosa rimane irriducibilmente umano? E se una macchina non impara mai a diventare indifferente, chi dei due sta mettendo in scena l’empatia?
Autore
 Angela D’Onghia e Simona Vacca sono un duo di artiste multimediali con base a Roma. Le loro pratiche individuali affrontano la tecnologia da prospettive differenti, mettendo in relazione ricerca critica, media interattivi, arti performative e corporeità.
La ricerca di Angela D’Onghia ruota attorno a tecnologia, politica e media, esplorandone le strutture estetiche e ideologiche. Il suo lavoro indaga l’etica delle macchine, le narrazioni del potere e l’ecologia dell’informazione. Piuttosto che cercare risposte definitive, la sua pratica crea occasioni di riflessione critica...